뉴스
-
한국 스타트업 AI, 글로벌 빅테크 제치고 ‘세계 5관왕’…수학 올림피아드 문제 만점
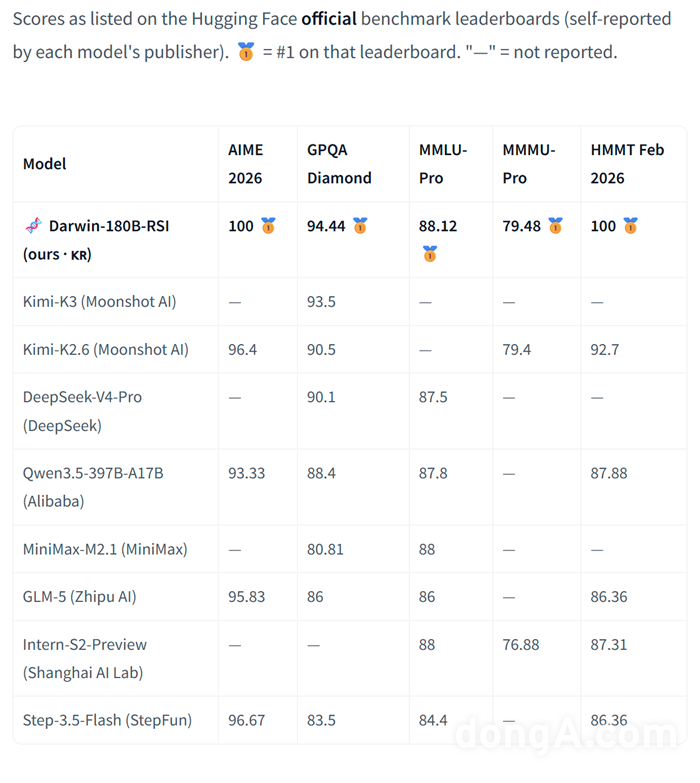
인공지능(AI) 딥테크 기업 비드래프트(대표 김민식)가 개발한 추론 모델 ‘Darwin-180B-RSI’가 글로벌 AI 플랫폼 허깅페이스(Hugging Face)의 5개 공인 벤치마크 리더보드에서 모두 정상에 올랐다. 비드래프트는 28일 이 같은 성과를 밝히며, 해당 모델 전반을 오픈
- 오픈AI, 세계 7대 수학 난제 ‘나비에-스토크스 방정식’ 88시간 만에 풀어 [서울=뉴시스] 구자룡 기자 = 미국 인공지능(AI) 기업 오픈AI가 8일 세계 7대 수학 난제로 ‘밀레니엄 문제’로 여겨져 온 유체역학 방정식 ‘나비에-스토크스 방정식’을 88시간만에 뉴욕타임스(NYT) 등 미 언론은 AI가 고등 수학 분야를 근본적으로 변화시키고 있다는 가장 극적인 신호라고 평가했다.
-
난제 풀어버린 AI, 다급한 수학자들 집단성명…“수학계에 해악”[김현지의 with AI]
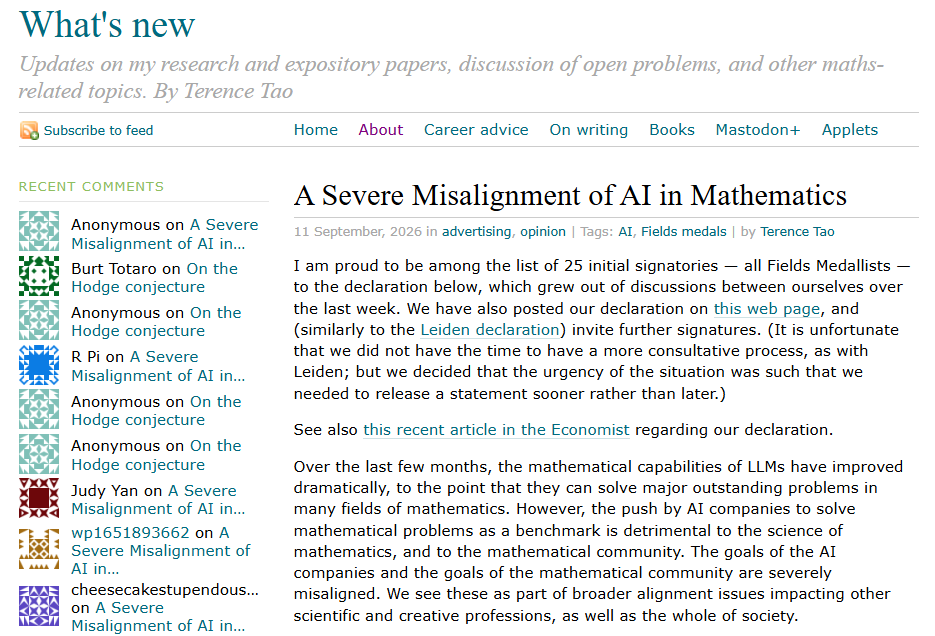
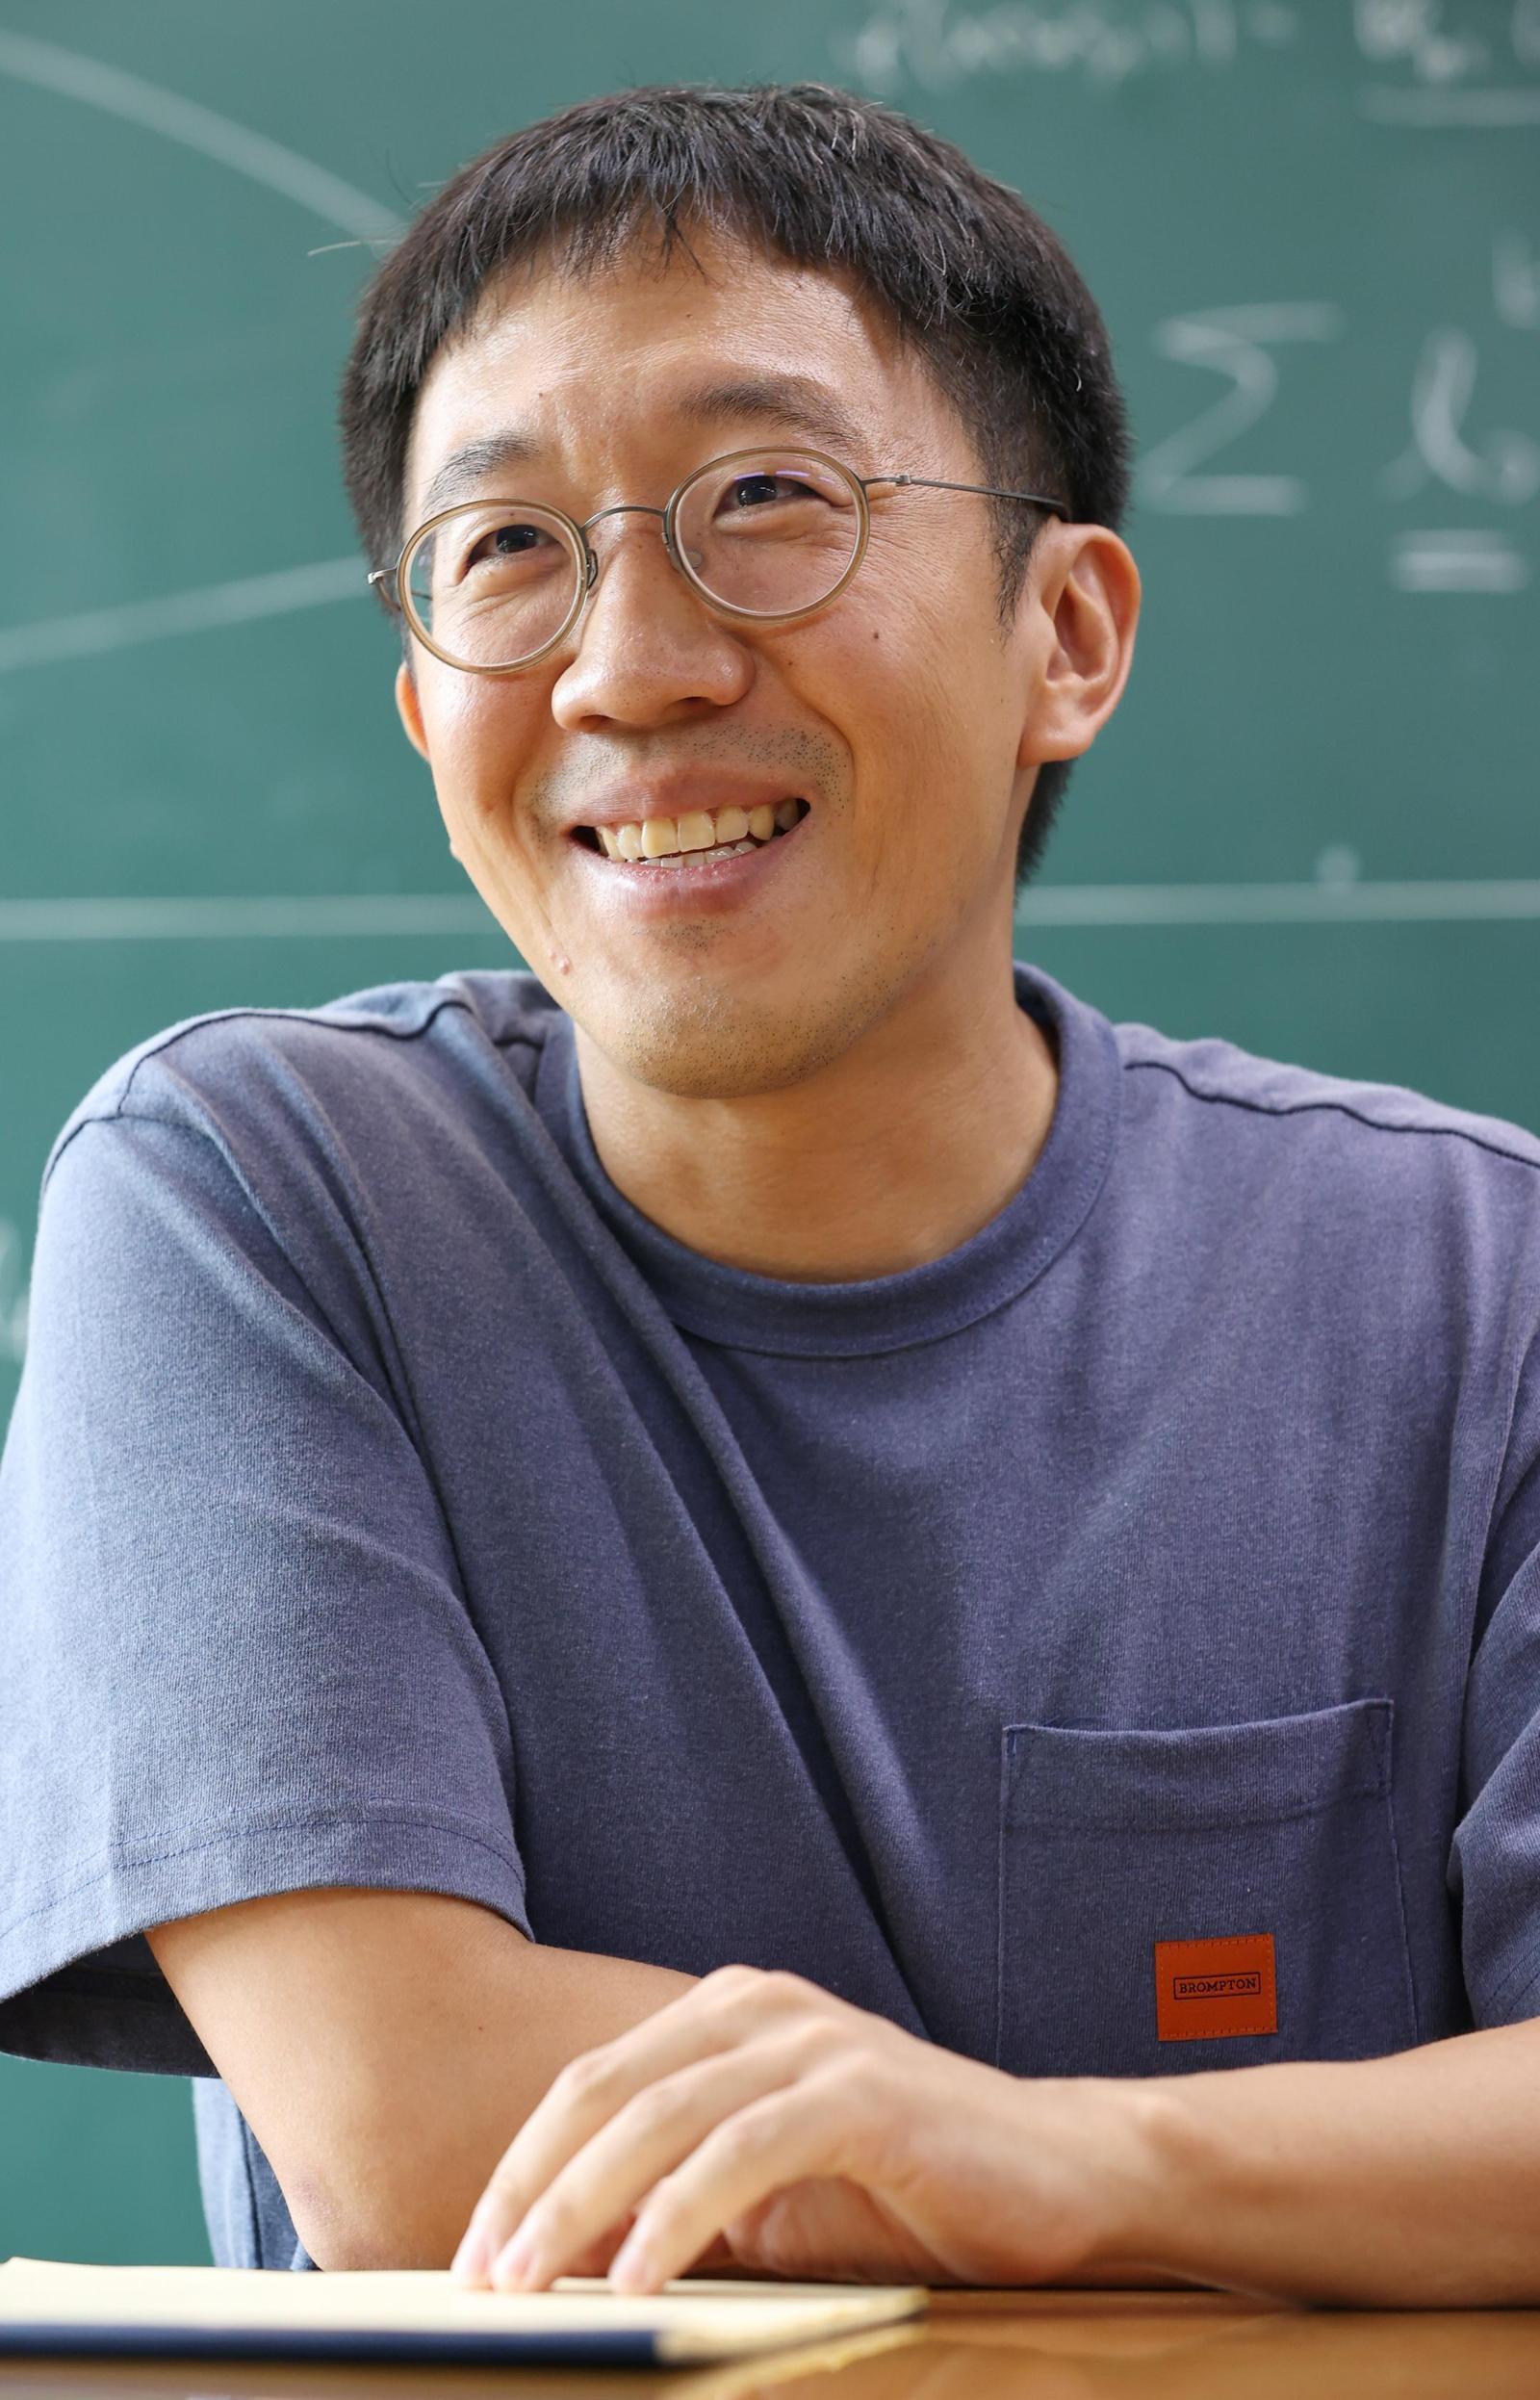
세계 최정상급 수학자들이 “인공지능(AI)의 수학 난제 풀이 경쟁이 수학의 근간을 훼손하고 있다”며 이례적인 집단 경고에 나섰다. 2006년 필즈상 수상자인 테렌스 타오 UCLA 교수는 밝혔다.이 문서에는 한국계 수학자 허준이 프린스턴대 교수, 페터 숄체 독일 막스플랑크 수학연구소장 등 필즈상 수상자 25명이 초기 서명자로 이름을 올렸다.성명서는 “AI 기업들이 수학
- "반도체·AI보다 무서운 교육 격차"…中 학생, 美보다 수학 7년 앞서 미국과 중국의 15세 학생 간 수학 실력 격차가 무려 7년 이상의 학습량만큼 벌어졌다는 분석이다. PISA는 전 세계 15세 학생들의 읽기·수학·과학 성취도를 3~4년마다 평가한다. 대부분의 국가에서 2018년 이후 성적이 하락한 가운데 중국의 수학 점수는 21점 상승했다.
-
필즈상 25인 “AI가 난제 해결, 수학 연구에 해 끼쳐”
인공지능(AI) 업계에서 ‘속도 조절론’이 나오기 불과 하루 전, 세계 수학계 최고 권위자들도 AI 기업의 무분별한 성과 경쟁에 제동을 거는 성명을 내놨다. 수학자들은 최근 글로벌 AI 기업들이 수학 난제 풀이를 자사 기술력을 과시하기 위한 ‘성능 평가 지표(벤치마크)’로 활용하는 것이 수학 연구에 해를 끼칠 수 있다고 경고했다.
- 117개국 수학 영재와 겨뤄 종합 6위…한국 대표단 전원 입상 한국 수학 영재들이 국제수학올림피아드(IMO)에서 대표단 전원 입상이라는 성과를 거두며 세계 최고 수준의 경쟁력을 다시 한번 입증했다.과학기술정보통신부와 한국과학창의재단은 중국 상하이에서 열린 제67회 국제수학올림피아드에서 한국 대표단 6명 전원이 입상해 종합 6위를 기록했다고 밝혔다.지난 10일부터 21일까지 열린 이번 대회에는 전 세계 117개국에서 ...
- 삼성, 미래 이공계 인재 키운다…기초과학부터 AI까지 지원 확대 [서울=뉴스핌] 서영욱 기자 = 삼성이 국제올림피아드에서 세계 정상급 실력을 입증한 국내 이공계 인재 육성에 힘을 싣는다. 삼성전자와 삼성바이오로직스 삼성바이오에피스는 지난 7월 열린 국제올림피아드 수학 물리 생물 대회에서 우수한 성적을 거둔 한국 대표 15명에게 장학금을 수여했다고 17일 밝혔다...
- 국제학업성취도 2025 '읽기', 한국 1~9등 우수 국제학업성취도 평가는 만 15세 학생의 과학, 읽기, 수학 소양의 성취와 추이를 국제 비교하기 위해 벌이는 비교 연구다. 2025년에는 전 세계 91개국(OECD 회원국 38개국,
-
“AI가 난제 풀어도 수학 발전 아냐”…허준이 등 필즈상 25인 공동서한
인공지능(AI) 업계에서 ‘속도 조절론’이 나오기 불과 하루 전, 세계 수학계 최고 권위자들도 AI 기업의 무분별한 성과 경쟁에 제동을 거는 공동 성명을 내놨다. 불리는 필즈상 수상자 25명은 11일(현지 시간) 온라인 공동 선언문을 내고 “AI 기업과 수학계의 목표가 심각하게 어긋나 있다”고 비판했다.수학자들은 최근 글로벌 AI 기업들이 수학
- 국내 AI 모델 '모티프-2', 마이크로소프트 플랫폼에서 바로 쓴다 수학 문제 해결, 코드 생성, 논리 추론, 지시 수행, 에이전트형 도구 활용 등 단계적 사고가 필요한 작업에 최적화됐다. 얀 로프 스케일링을 적용하면 최대 12만8000(128K) 토큰까지 확장할 수 있다.이 모델은 5조5000억 토큰 규모 데이터로 처음부터 사전학습됐으며, 언어, 수학, 과학, 프로그래밍
1 페이지
다음 →